CS185/285 (Spring 2026) - Deep Reinforcement Learning 2
00_과거 정보와 Causal Confusion
왜 과거의 정보를 포함시키는 것이 imitation learning을 나쁘게 만들 수도 있을까?
- 불필요한 정보가 오히려 나쁜 결과를 불러올 수 있다.
- Distribution shift: 학습된 data 분포와 실제 test data 분포가 달라지는 현상이다.
Causal Confusion
직관적으로 model에게 더 많은 정보를 주면 성능이 더 나빠지지 않을 것이라고 생각하곤 한다. 그러나 causal inference 관점에서는 추가된 정보에 의존하는 방식이 잘못될 수 있다.
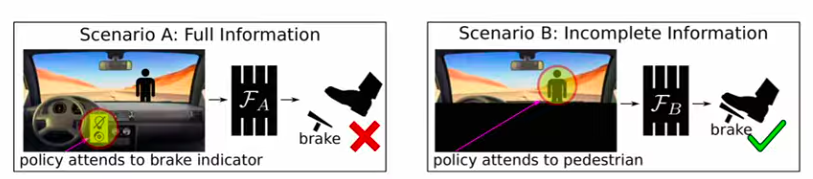
왼쪽의 policy는 brake indicator에 주목하고, 오른쪽의 policy는 indicator가 가려진 상태에서 보행자에 주목한다. 노란색 원과 자홍색 선은 policy가 주목하는 대상을 나타낸다.
브레이크를 밟으면 brake indicator가 켜지고, 브레이크를 밟고 있는 동안 계속 켜져 있다. 이 data로 학습하면 model은 “brake indicator가 켜져 있으면 brake를 밟는다”는 잘못된 규칙을 학습할 수 있다. 이렇게 학습된 policy는 indicator가 꺼진 상태에서 시작하면, 보행자가 나타나도 brake를 밟지 않는 문제가 생길 수 있다.
casual confusion은 다음과 같은 실제 시나리오에서 좀더 직관적으로 이해하기 쉽다.
- 장애물을 봄 → brake를 밟음 → brake indicator가 켜짐
위 시나리오에서 model은 “장애물을 봄 → brake를 밟음”이라는 인과관계보다, brake indicator와 brake action 사이의 상관관계를 학습하기 쉽다. 과거 정보에는 이전 action의 흔적이 포함될 수 있어, 이런 상관관계에 의존하게 될 수 있다.
즉, model은 causality와 correlation을 구분하지 않고 loss를 쉽게 낮추는 feature에 의존할 수 있다.
더 본질적인 문제는 이런 규칙이 training distribution 위에서는 완벽하게 작동할 수도 있다는 점이다. 그래서 같은 expert distribution에서 얻은 training/validation loss만 봐서는 문제를 알아내기 어렵다. Policy를 실제 closed loop로 실행했을 때 실패가 드러날 수 있으며, 이것이 imitation learning에서 closed-loop 평가가 중요한 이유다.
Q1) History를 추가하면 causal confusion이 완화되는가?
과거 action의 흔적에 의존하는 경우에는 오히려 악화되기 쉽다. History에 포함된 이전 action의 흔적이 잘못된 상관관계를 학습하는 단서가 될 수 있기 때문이다.
Q2) DAgger는 causal confusion을 완화할 수 있는가?
그렇다. DAgger는 policy가 실제로 방문한 observation에 expert의 올바른 action을 labelling하고 재학습하면서 distributional shift를 줄일 수 있다. 이 과정에는 많은 data와 반복이 필요할 수 있다.
예를 들어 brake와 brake indicator의 상관관계에 잘못 의존하고 있다면, policy가 방문한 상황 중 “brake indicator가 꺼져 있어도 장애물이 있으면 brake를 밟아야 한다”는 data를 계속 추가할 수 있다. 이를 통해 brake indicator에 대한 잘못된 의존을 줄이고, 장애물에 반응해 brake를 밟도록 학습할 수 있다.
01_Multimodal Behavior
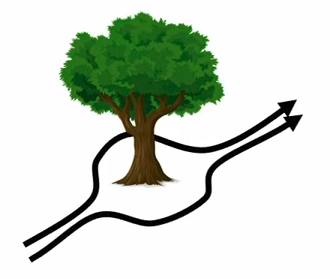
Multimodal behavior에서 생기는 문제는 그림의 검은 화살표처럼 나무를 피하는 왼쪽, 오른쪽 두 가지 길이 있을 때, 이를 평균내어 나무가 있는 방향으로 가는 것이다.
이를 우리가 사용하는 action에 연결해보면, Discrete action에서는 left와 right를 각각 유지할 수 있다. Continuous action을 하나의 Gaussian으로 표현하고 그 mean을 action으로 사용하면 문제가 생길 수 있다. Left와 right의 확률이 같을 때, 두 방향의 평균을 선택하게 되는 것이다.
이를 수학적으로 한번 봐보자. 같은 observation에서 왼쪽으로 피하는 action을 $-1$, 오른쪽으로 피하는 action을 $+1$이라고 하고, 수집한 $N$개의 action sample을 $a_1,\ldots,a_N$이라고 하자.
Maximum likelihood는 어떤 mean을 줄까? 먼저 variance $\sigma^2>0$을 고정하고, negative log-likelihood를 $\mu$에 대해 미분한 뒤 0으로 두면 다음과 같다.
\[\begin{aligned} \mathcal{L}(\mu) &=\frac{1}{2\sigma^2}\sum_{i=1}^{N}(a_i-\mu)^2+\text{const} \\ \frac{\partial\mathcal{L}}{\partial\mu} &=-\frac{1}{\sigma^2}\sum_{i=1}^{N}(a_i-\mu)=0 \\ &\Longrightarrow\quad \mu^\star=\frac{1}{N}\sum_{i=1}^{N}a_i \end{aligned}\]즉, maximum likelihood로 유도되는 mean은 sample들의 mean이 된다. Data가 ${-1,+1}$ 절반씩이면 $\mu^\star=0$이고, 이 mean을 action으로 사용하면 나무를 향해 직진하게 된다. 이는 주어진 model의 maximum-likelihood solution 자체가 multi-modal한 환경에서 이를 평균내버려 발생한다.
Variance를 함께 학습해도 이 문제는 해결되지 않는데, 아래의 maximum-likelihood 추정식을 보면 그 이유를 좀 더 직관적으로 이해할 수 있다.
\[\sigma^{2\star}=\frac{1}{N}\sum_{i=1}^{N}(a_i-\mu^\star)^2=1\]앞서 구한 mean은 $0$이고, $-1$과 $+1$은 모두 mean에서 $1$만큼 떨어져 있으므로 variance는 $1$이 된다. 따라서 학습된 분포는 $\mathcal{N}(0,1)$이다. Variance는 mean 주변으로 action이 얼마나 퍼지는지를 조절할 뿐, 왼쪽과 오른쪽에 각각 mode를 만들지는 못한다. 여전히 평균 $0$에서 확률밀도가 가장 큰 unimodal distribution인 것이다.
즉, variance까지 학습하더라도 하나의 Gaussian으로는 왼쪽과 오른쪽의 두 mode를 표현할 수 없다는 한계가 남는다.
이를 해결하기 위한 방법을 두가지를 다룬다.
- Discretization with high-dimensional action spaces
- More expressive continuous distributions
Discretization with high-dimensional action spaces
앞서 말했듯이, continuous action을 하나의 Gaussian으로 표현하면 multimodal behavior의 서로 다른 action을 평균내는 문제가 발생할 수 있다. 이를 해결하는 방법 중 하나는 continuous action space를 이산화하는 것이다. 여기서는 high-dimensional action space에서의 discretization을 다룬다.
다만 discretization에도 문제가 있는데, 먼저 이 문제를 살펴본 뒤 그 해결 방안을 설명한다.
discretization는 차원이 낮을수록 쉽고, 차원이 높아질수록 필요한 bin 수가 기하급수적으로 늘어난다. 각 차원을 $K$개의 bin으로 나누면, 1차원에서는 $K$개, 2차원에서는 $K^2$개, $D$차원에서는 $K^D$개의 조합이 필요하다. 즉, 높은 차원에서의 discretization은 굉장히 어려워 진다.
이를 해결하기 위한 방법은 한 번에 하나의 dimension만 discretize하고 순서대로 선택하는 것이다. 이 방법을 Autoregressive discretization이라고 한다.
Autoregressive Discretization
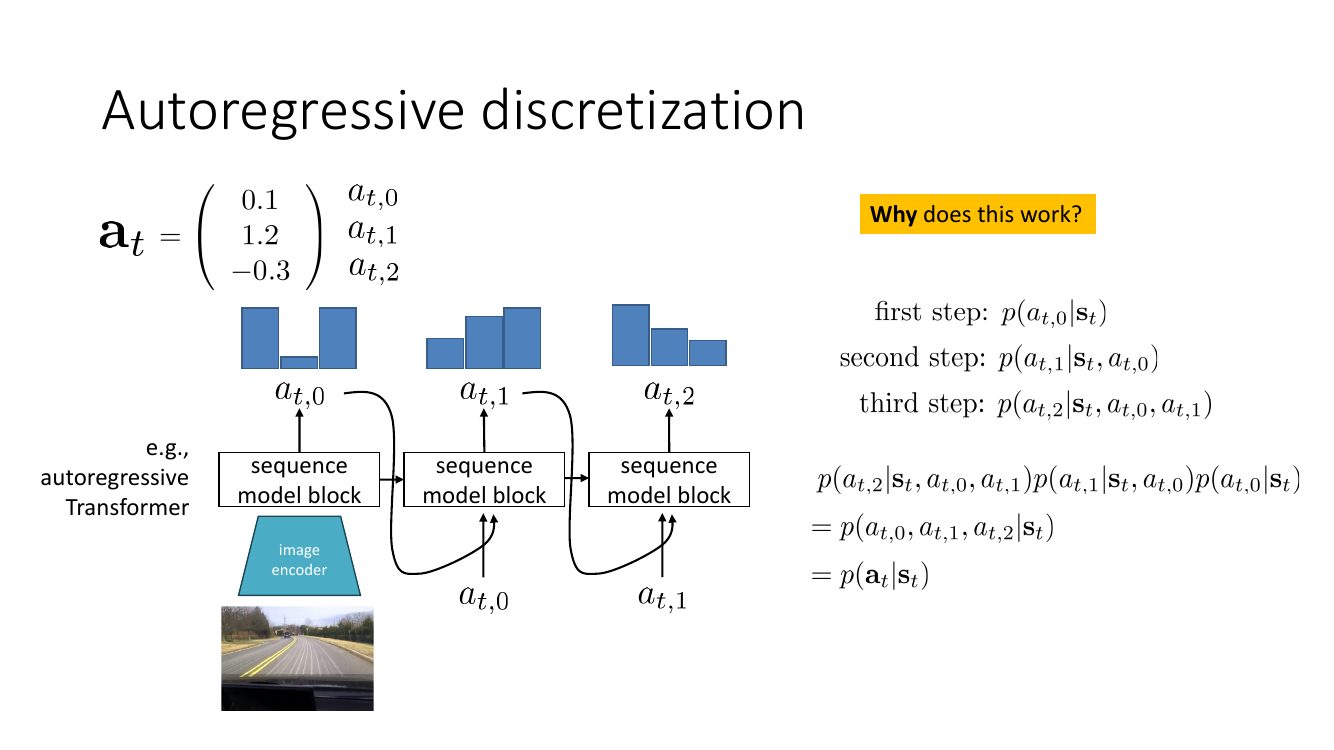
Autoregressive discretization은 각 차원의 확률분포를 순서대로 예측하는 방법이다. 예를 들어 세 차원의 action을 생성한다면, 첫 번째 차원의 분포에서 action 값을 선택하고, 그 값을 조건으로 두 번째 차원의 분포를 예측한다. 세 번째 차원은 앞서 선택한 두 값을 모두 조건으로 사용한다. 이때 autoregressive Transformer를 사용할 수 있다.
그림의 파란색 막대는 각 차원의 확률분포를, 화살표는 앞서 선택한 action 값이 다음 예측의 입력으로 전달되는 흐름을 나타낸다. 확률의 chain rule에 따라 다음과 같이 전체 action의 분포를 표현할 수 있다.
\[\begin{aligned} p(\mathbf{a}_t\mid s_t) =p(a_{t,0}\mid s_t)\,p(a_{t,1}\mid s_t,a_{t,0})\times p(a_{t,2}\mid s_t,a_{t,0},a_{t,1}) \end{aligned}\]이 방식은 한 action을 생성할 때 필요한 logit 수를 $K^D$개에서 $K\times D$개로 줄인다. 각 차원에서 $K$개의 logit을 $D$번 출력하며, 표현할 수 있는 action 조합은 여전히 $K^D$개다.
More Expressive Continuous Distributions
이는 discretization을 하지 않고 continuous distribution 자체를 다루는 방법이다.
그러나 input에 noise를 추가하기만 하면 model이 이를 무시하고 하나의 mode에만 집중할 수 있다. 그래서 model이 input noise의 서로 다른 sample들을 서로 다른 action mode와 연결하도록 학습시켜야 한다.
이를 위해 training 방식을 바꿔야 하며, flow model, diffusion 등 다양한 방법을 사용할 수 있다.
Flow Matching
Flow matching은 observation $\mathbf{o}_t$를 조건으로, Gaussian noise를 expert action으로 옮기는 velocity를 학습한다. $t$는 environment의 time step이고, $\tau\in[0,1]$는 noise에서 action으로 이동하는 경로 위의 시간이다.
$\mathcal{D}$는 expert의 observation-action pair를 모은 dataset이며, $B$는 batch size, $\alpha$는 learning rate이다. 시간 분포 $p(\tau)$는 예를 들어 $\mathcal{U}(0,1)$로 둘 수 있다.
$\mathbf{a}{t,\tau}^{(j)}$는 noise $\mathbf{a}{t,0}^{(j)}$와 expert action $\mathbf{a}t^{(j)}$ 사이를 선형 보간한 값이다. $\tau=0$이면 noise이고, $\tau=1$이면 expert action이 된다. 이 경로를 $\tau$에 대해 미분하면 target velocity $\mathbf{u}^{(j)}=\mathbf{a}_t^{(j)}-\mathbf{a}{t,0}^{(j)}$를 얻는다. Network의 예측값 $\hat{\mathbf{v}}^{(j)}$가 이 target에 가까워지도록 제곱오차를 줄이며 학습한다.
Sampling과 integration step
학습이 끝나면 base distribution에서 noise를 sample하고, 학습된 velocity field를 따라 이동시켜 final distribution의 sample을 생성한다. 이때 각 위치에서 이동할 방향과 속도를 정하는 것은 $v_\theta$이고, integrator는 이 velocity를 이용해 이동 경로를 수치적으로 계산하는 방법이다.
예를 들어 Euler integration은 현재 위치의 velocity 방향으로 한 step씩 이동한다. $\tau=0$에서 $1$까지를 $K$개의 동일한 step으로 나누면 $\Delta\tau=1/K$이며, 각 step의 update는 다음과 같다.
\[\mathbf{a}_{t,\tau+\Delta\tau} \leftarrow\mathbf{a}_{t,\tau} +\Delta\tau\,v_\theta(\mathbf{o}_t,\mathbf{a}_{t,\tau},\tau)\]경로를 따라 velocity의 방향과 크기가 거의 일정하다면, 한 번의 큰 step으로도 최종 위치를 잘 근사할 수 있다. 반대로 경로가 많이 휘거나 velocity가 빠르게 변하면, step을 작게 나누어 방향과 속도를 다시 계산해야 한다. Euler integration에서는 이렇게 곡선 경로를 여러 개의 짧은 직선 구간으로 근사한다.
예를 들어 action 생성에는 10 step, image 생성에는 100 step을 사용할 수 있다. 필요한 step 수는 model, integrator, 원하는 생성 품질에 따라 달라진다.
02_Action Chunking
High frequency로 동작을 제어해야 하는 로봇 시스템에서는 action chunking이 유용하다. Action chunking은 한 번의 policy inference로 여러 time step의 action을 함께 예측하고, 이를 순서대로 실행하는 방법이다.
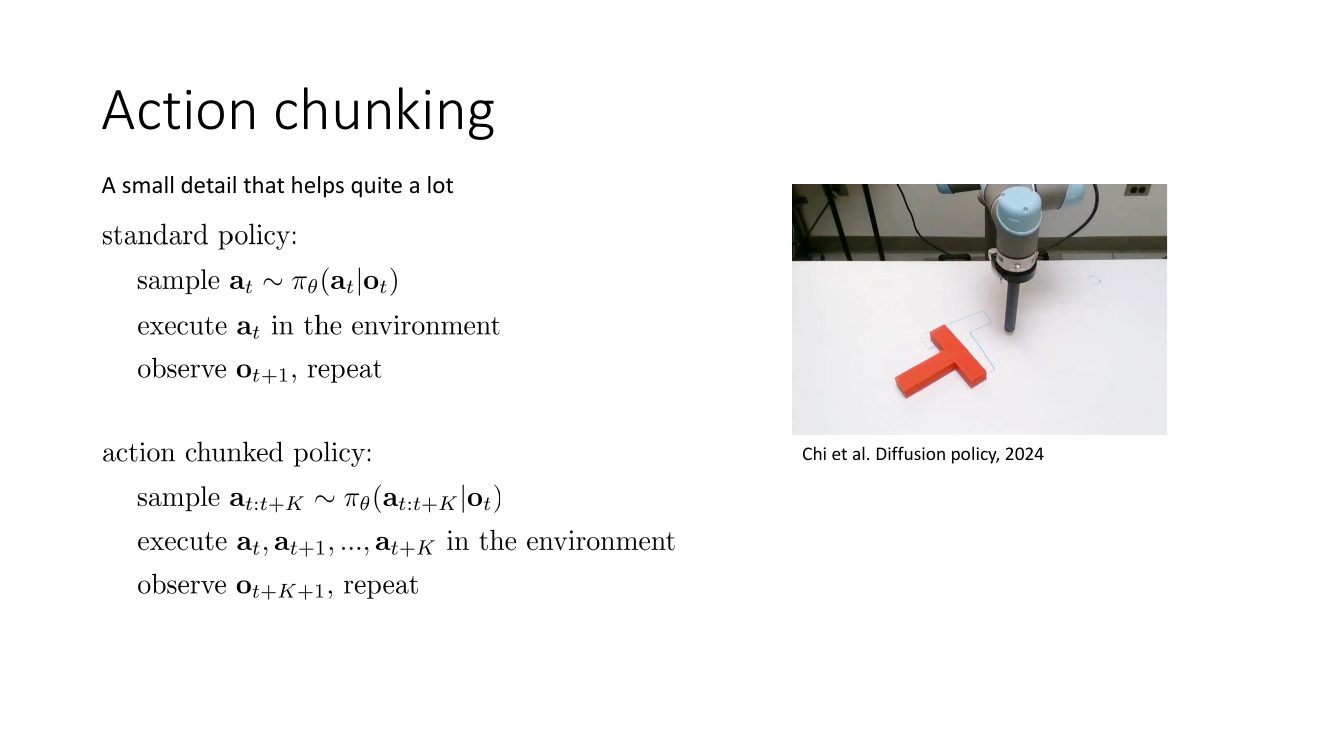
그림의 왼쪽은 두 policy의 실행 과정을 비교하고, 오른쪽은 로봇 팔로 빨간색 T자 물체를 미는 task를 보여준다.
| 구분 | Standard policy | Action chunked policy |
|---|---|---|
| Action 예측 | $\mathbf{a}t\sim\pi\theta(\mathbf{a}_t\mid\mathbf{o}_t)$ | $\mathbf{a}{t:t+K}\sim\pi\theta(\mathbf{a}_{t:t+K}\mid\mathbf{o}_t)$ |
| Environment에서 실행 | $\mathbf{a}_t$ 하나를 실행한다. | $\mathbf{a}t,\mathbf{a}{t+1},\ldots,\mathbf{a}_{t+K}$를 순서대로 실행한다. |
| 다시 관측하고 예측 | $\mathbf{o}_{t+1}$을 받아 다음 action을 예측한다. | $\mathbf{o}_{t+K+1}$을 받아 다음 chunk를 예측한다. |
여기서 $\mathbf{a}_{t:t+K}$는 $t$부터 $t+K$까지의 action을 묶은 것으로, 총 $K+1$개의 action을 의미한다. 위 비교는 예측한 chunk 전체를 실행한 뒤 다시 관측하는 기본적인 경우다.
여러 action을 미리 예측해 두면 로봇은 높은 주기로 action을 실행하면서도 policy를 매 제어 step마다 다시 호출하지 않아도 된다. 특히 여러 번의 sampling 계산이 필요한 diffusion policy에서는 policy 호출 횟수를 줄이는 것이 유용하다. 다만 한 번에 실행하는 action이 많아질수록 새로운 observation을 반영하기까지의 간격도 길어져, 환경 변화에 늦게 반응할 수 있다.
Diffusion Policy에서도 action sequence를 예측하는 방식을 사용했다. 구체적으로는 예측한 sequence의 앞부분을 실행한 뒤, 새로운 observation을 받아 다시 예측하는 receding horizon control을 사용한다. 예측할 action의 길이와 실제로 실행할 길이를 나누어 정할 수 있어, 이후 동작을 함께 계획하면서도 중간에 새 observation을 반영할 수 있다.
Q) 실제로 실행하지 않는 미래 action까지 예측하도록 학습시키는 이유는 무엇일까?
그 이유를 명확하게 단정하기는 어렵다. 다만 짧은 action sequence만 output으로 내도록 학습하는 경우와, 실행하지 않을 뒷부분까지 포함해 긴 sequence를 예측하도록 학습하는 경우에는 network가 서로 다른 것을 배울 수도 있다.
03_Some Common Tricks
1. 너무 완벽한 dataset이 오히려 불리할 수 있다
실제 환경에서는 observation에 noise가 섞이거나, 학습할 때 보지 못한 상황이 생길 수 있다. 그런데 이상적인 조건에서 성공한 demonstration만 학습하면, 이런 상황에 대처하지 못할 수 있다.
그래서 적당한 noise와 다양한 상황을 포함한 dataset이 더 도움이 될 수도 있다. 실제 환경에서 생길 법한 작은 변화와, 그 상황에서 어떻게 대응해야 하는지를 함께 담는 것이 중요하다.
2. Data Augmentation
앞서 설명한 NVIDIA의 자율주행 사례가 대표적인 예다. 카메라 이미지에 shift와 rotation을 적용해 차량이 경로에서 벗어난 상황을 만들고, 그 상황에서 원래 경로로 돌아오도록 steering label도 함께 보정했다. 이렇게 기존 data를 변형하면 정상적인 주행과 경로를 벗어났을 때의 복귀 행동을 함께 학습시킬 수 있다.
3. Imitation Learning with Pre-training
모델이 실수하거나 경로를 벗어난 상황에 대처하려면, 그런 상황도 학습 data에 포함되어야 한다. 하지만 그 상황을 만든 suboptimal action까지 그대로 따라 하게 만들고 싶지는 않다. 이때 pre-training과 post-training을 나누는 방법을 사용할 수 있다.
Pre-training에서는 품질이 서로 다른 광범위한 data를 사용해 다양한 상황과 행동을 학습시킨다. 성공적인 demonstration, 실수와 복귀 과정을 함께 포함할 수 있다.
Post-training에서는 목표 task를 잘 수행한 좋은 demonstration으로 추가 학습을 시킨다. Data가 다루는 상황은 상대적으로 좁지만, 그 안에는 원하는 행동이 잘 담겨 있다. Pre-training에서 여러 상황을 통해 배운 내용을 바탕으로, 실제로 수행할 task에서 좋은 action을 선택하도록 policy를 조정하는 것이다.
이는 LLM을 광범위한 data로 pre-training한 뒤, 좋은 응답을 담은 data로 추가 학습시키는 방식과 비슷하다. Imitation learning에서도 사용되며, $\pi_0$가 그 예다. $\pi_0$는 사전 학습된 VLM을 기반으로 다양한 robot과 task의 data를 학습한 뒤, 특정 task의 고품질 demonstration으로 post-training을 수행했다.