CS185/285 (Spring 2026) - Deep Reinforcement Learning 3
00_Markov Chain
Markov chain은 state space $\mathcal{S}$와 transition operator $\mathcal{T}$로 표현한다.
\[\mathcal{M}=\{\mathcal{S},\mathcal{T}\}\]여기서는 $\mathcal{S}={1,\ldots,n}$인 유한한 state space를 다루며, transition probability는 시간에 따라 변하지 않는다고 가정한다.
State와 Markov Property
현재 state $s_t$가 주어지면, 다음 state $s_{t+1}$는 과거 state $s_0,\ldots,s_{t-1}$와 conditionally independent하다.
\[p(s_{t+1}\mid s_t,s_{t-1},\ldots,s_0) =p(s_{t+1}\mid s_t)\]직관적으로는 현재 state가 미래를 예측하는 데 필요한 모든 정보를 담고 있으므로, 현재 state를 알고 있다면 이전 history를 추가로 알 필요가 없다는 뜻이다.
State Distribution의 변화
Transition을 operator라고 부르는 것은 현재 state의 distribution을 다음 state의 distribution으로 바꾸는 연산으로 볼 수 있기 때문이다. 여기서는 시간에 따라 state distribution이 어떻게 변하는지를 살펴본다.
현재 state $s_t$를 marginalize하면 next state의 distribution을 얻는다.
\[p(s_{t+1}) =\sum_{s_t\in\mathcal{S}}p(s_{t+1}\mid s_t)p(s_t)\]Transition Operator의 Matrix 표현
시간 $t$의 state distribution을 column vector $\mu_t$로 표현하면 다음과 같다.
\[\mu_t= \begin{bmatrix} p(s_t=1) \\ p(s_t=2) \\ \vdots \\ p(s_t=n) \end{bmatrix}\]Transition matrix의 원소는 다음과 같이 정의한다.
\[\mathcal{T}_{i,j}=p(s_{t+1}=i\mid s_t=j)\]즉, 열 $j$는 현재 state를, 행 $i$는 다음 state를 나타낸다. 현재 state $j$에서 이동할 수 있는 모든 다음 state의 확률을 합하면 $1$이므로, 각 열의 합은 $1$이다.
이렇게 정의하면 앞의 summation은 정확히 matrix-vector multiplication이 된다.
\[\mu_{t+1}=\mathcal{T}\mu_t\]$\mathcal{T}$를 $\mu_t$에 곱하면 각 state로 이동할 확률을 합산해 다음 distribution $\mu_{t+1}$을 얻는다. 이처럼 고정된 transition matrix는 state distribution에 작용하는 linear operator이다.
01_Markov Decision Process
Markov Decision Process(MDP)는 Markov chain에 action과 reward를 추가한 모델이다. Agent가 선택한 action에 따라 다음 state의 분포가 달라지고, reward는 그 선택을 평가하는 기준이 된다.
MDP의 구성 요소
\[\mathcal{M}=\{\mathcal{S},\mathcal{A},\mathcal{T},r\}\]- $\mathcal{S}$: state space이며, $s\in\mathcal{S}$이다.
- $\mathcal{A}$: action space이며, $a\in\mathcal{A}$이다. State space와 마찬가지로 discrete일 수도, continuous일 수도 있다.
- $\mathcal{T}$: transition operator이다. MDP에서는 $p(s_{t+1}\mid s_t,a_t)$로 표현하며, 현재 state와 선택한 action에 의존한다.
- $r:\mathcal{S}\times\mathcal{A}\to\mathbb{R}$: reward function이다. 여기서는 $r(s,a)$를 state $s$에서 action $a$를 선택했을 때의 expected immediate reward로 둔다.
Action에 따른 Transition
State와 action이 모두 유한한 경우, transition은 다음과 같은 third-order tensor로 표현할 수 있다.
\[\mathcal{T}_{i,j,k} =p(s_{t+1}=i\mid s_t=j,a_t=k)\]여기서 $i$는 다음 state, $j$는 현재 state, $k$는 선택한 action이다. Action $k$를 하나 고정하면 $\mathcal{T}_{:,:,k}$는 앞서 본 transition matrix가 된다. 즉, action마다 서로 다른 transition matrix를 갖는 것으로 볼 수 있다.
02_Partially Observed Markov Decision Process
State와 Observation
Partially Observed Markov Decision Process(POMDP)는 실제 state를 직접 알 수 없고, observation을 통해 환경을 파악해야 하는 경우를 다룬다. Observation에는 측정 오차가 섞이거나 state의 일부 정보만 담길 수 있다.
\[\mathcal{M}=\{\mathcal{S},\mathcal{A},\mathcal{O},\mathcal{T},\mathcal{E},r\}\]- $\mathcal{S}$: 실제 state의 공간이며, $s\in\mathcal{S}$이다.
- $\mathcal{A}$: action space이며, $a\in\mathcal{A}$이다.
- $\mathcal{O}$: observation space이며, $o\in\mathcal{O}$이다.
- $\mathcal{T}$: state의 변화를 나타내는 transition operator이며, $p(s_{t+1}\mid s_t,a_t)$로 표현한다.
- $\mathcal{E}$: state에서 어떤 observation이 나오는지를 나타내는 emission operator이다. 여기서는 $p(o_t\mid s_t)$로 표현한다.
- $r:\mathcal{S}\times\mathcal{A}\to\mathbb{R}$: reward function이며, $r(s,a)$는 state $s$에서 action $a$를 선택했을 때의 expected immediate reward이다.
Emission Operator와 관측 구조
MDP와 비교하면 observation space $\mathcal{O}$와 emission operator $\mathcal{E}$가 추가된다. 같은 state에서도 noise 때문에 다른 observation이 나올 수 있고, 반대로 서로 다른 state에서 같은 observation이 나올 수도 있다.
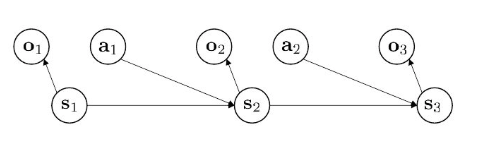
그림에서 아래쪽의 $s_1\to s_2\to s_3$는 실제 state의 변화를 나타낸다. $s_t$와 $a_t$에서 $s_{t+1}$로 향하는 화살표는 다음 state가 현재 state와 action에 의존한다는 뜻이고, $s_t\to o_t$는 해당 state에서 observation이 생성되는 관계를 나타낸다.
실제 state가 Markov property를 만족하더라도 observation 하나에는 필요한 정보가 모두 담겨 있지 않을 수 있다. 이런 경우에는 과거 observation과 action이 현재 state를 추정하는 데 도움이 될 수 있다.
03_Trajectory Distribution과 State Marginal Distribution
여기서는 Trajectory distribution과 State Marginal distribution에 대해 설명한다.
Trajectory Distribution
초기 state $s_1$에서 시작해 $H$번 action을 실행하면 다음과 같은 trajectory를 얻는다.
\[\tau=(s_1,a_1,\ldots,s_H,a_H,s_{H+1})\]이 trajectory의 확률은 초기 state의 확률, 각 action을 선택할 확률, 다음 state로 이동할 확률을 모두 곱한 것이다.
\[p_\theta(\tau) =p(s_1)\prod_{t=1}^{H} \pi_\theta(a_t\mid s_t)p(s_{t+1}\mid s_t,a_t)\]State Marginal Distribution
시간 $t$의 state distribution $p_\theta(s_t)$를 구하려면, trajectory에서 $s_t$를 제외한 모든 state와 action을 marginalize하면 된다.
\[\begin{aligned} p_\theta(s_t) &=\sum_{\substack{a_{1:H},\,s_{1:t-1},\\s_{t+1:H+1}}}p_\theta(\tau) \\ &=\sum_{a_{1:t-1},\,s_{1:t-1}} p(s_1)\prod_{t'=1}^{t-1} \pi_\theta(a_{t'}\mid s_{t'}) p(s_{t'+1}\mid s_{t'},a_{t'}) \end{aligned}\]여기서 $s_{1:t-1}$은 $s_1,\ldots,s_{t-1}$을, $a_{1:t-1}$은 $a_1,\ldots,a_{t-1}$을 뜻한다. 시간 $t$부터의 action과 그 이후 state를 모두 합하면 해당 조건부 확률의 합이 $1$이 되므로, 두 번째 줄에는 $s_t$에 도달하기 전의 항들만 남는다.
위 식은 discrete한 state와 action을 기준으로 썼으며, continuous인 변수는 summation을 integral로 바꾸면 된다.
Policy를 실행해서 State를 Sampling하는 방법
이 복잡한 distribution을 직접 계산할 필요는 없다. 초기 state $s_1\sim p(s_1)$에서 policy $\pi_\theta$를 실행하며 environment와 $t-1$번 상호작용한 뒤, 그때의 state $s_t$를 가져오면 된다. 이렇게 얻은 $s_t$가 바로 $p_\theta(s_t)$에서 뽑은 sample이다.
여러 sample이 필요하면 같은 초기 분포에서 rollout을 반복하고, 각 rollout의 시간 $t$에 해당하는 state를 모으면 된다.
04_RL의 objective
Expected Return의 최대화
RL의 objective는 trajectory distribution $p_\theta(\tau)$에서 sample한 trajectory의 cumulative reward expectation을 최대화하는 policy parameter $\theta$를 찾는 것이다. $H$번의 action을 실행하는 경우 다음과 같이 쓸 수 있다.
\[\theta^\star =\arg\max_\theta \mathbb{E}_{\tau\sim p_\theta(\tau)} \left[\sum_{t=1}^{H}r(s_t,a_t)\right]\]여기서 $\sum_{t=1}^{H}r(s_t,a_t)$는 trajectory의 return이다. RL은 자신이 만들어 내는 trajectory distribution의 expected return이 가장 높은 policy를 찾는다.
Stochastic environment에서는 같은 policy라도 서로 다른 trajectory가 나올 수 있다. 따라서 optimal policy도 낮은 return을 얻는 trajectory를 만들 수 있다.
Finite Horizon: State-Action Marginal Summation
Finite horizon의 RL objective는 각 시점의 state-action distribution에 대한 expectation을 $H$까지 더한 형태로 표현할 수 있다. Expected cumulative reward를 $J(\theta)$라고 하면 다음과 같다.
\[\begin{aligned} J(\theta) &=\mathbb{E}_{\tau\sim p_\theta(\tau)} \left[\sum_{t=1}^{H}r(s_t,a_t)\right] \\ &=\sum_{t=1}^{H} \mathbb{E}_{\tau\sim p_\theta(\tau)}[r(s_t,a_t)] \\ &=\sum_{t=1}^{H} \mathbb{E}_{(s_t,a_t)\sim p_\theta(s_t,a_t)}[r(s_t,a_t)] \end{aligned}\]State-Action Marginal의 정의
위 식에서 $p_\theta(s_t,a_t)$를 state-action marginal distribution이라고 부른다. Policy $\pi_\theta$를 실행했을 때, 시간 $t$에 state $s_t$에 있으면서 action $a_t$를 선택할 확률이다. 앞서 구한 state marginal에 현재 policy를 곱하면 얻을 수 있다.
\[\begin{aligned} p_\theta(s_t,a_t) &=\pi_\theta(a_t\mid s_t)p_\theta(s_t) \\ &=\pi_\theta(a_t\mid s_t) \sum_{a_{1:t-1},\,s_{1:t-1}} p(s_1) \\ &\qquad\times\prod_{t'=1}^{t-1} \pi_\theta(a_{t'}\mid s_{t'}) p(s_{t'+1}\mid s_{t'},a_{t'}) \end{aligned}\]Distribution과 Reward의 Vector 표현
이제 state와 action이 모두 유한하며, transition과 policy가 시간에 따라 변하지 않는 경우를 생각해 보자. State의 개수를 $n$, action의 개수를 $m$이라고 하면, 모든 state-action pair의 확률을 하나의 column vector로 모을 수 있다.
앞의 Markov chain에서는 $\mu_t$가 state만의 분포였지만, 여기서는 state-action pair의 분포로 다시 정의한다. Reward도 같은 순서로 나열해 vector $\mathbf{r}$로 둔다.
\[\mu_t= \begin{bmatrix} p_\theta(s_t=1,a_t=1) \\ p_\theta(s_t=1,a_t=2) \\ \vdots \\ p_\theta(s_t=n,a_t=m) \end{bmatrix}, \qquad \mathbf{r}= \begin{bmatrix} r(1,1) \\ r(1,2) \\ \vdots \\ r(n,m) \end{bmatrix}\]따라서 시간 $t$의 expected reward는 두 vector의 내적 $\mu_t^\top\mathbf{r}$로 표현할 수 있다.
Transition Matrix로 표현한 Objective
State-action pair를 하나의 state처럼 보면, 앞에서 사용한 Markov chain의 transition operator를 다시 적용할 수 있다. 현재 pair $(s,a)$에서 다음 pair $(s’,a’)$로 이동하려면 environment가 $s’$로 전이하고, policy가 그 state에서 $a’$를 선택해야 한다. 따라서 transition matrix를 다음과 같이 정의한다.
\[(\mathcal{T}_\theta)_{(s',a'),(s,a)} =p(s'\mid s,a)\pi_\theta(a'\mid s')\]열은 현재 state-action pair, 행은 다음 state-action pair를 나타낸다. 이 matrix에는 policy가 포함되어 있으므로 $\theta$에 의존한다.
\[\mu_{t+1}=\mathcal{T}_\theta\mu_t\]같은 transition matrix를 반복 적용하면 다음과 같다.
\[\mu_t=\mathcal{T}_\theta^{\,t-1}\mu_1\]여기서 $\mu_1$은 초기 state와 첫 action의 joint distribution이다.
\[(\mu_1)_{(s,a)}=p(s_1=s)\pi_\theta(a\mid s)\]이를 objective에 대입하면 다음과 같이 정리된다. 아래에서 $i$는 vector에 나열한 state-action pair의 index이다.
\[\begin{aligned} J(\theta) &=\sum_{t=1}^{H} \mathbb{E}_{(s_t,a_t)\sim p_\theta(s_t,a_t)}[r(s_t,a_t)] \\ &=\sum_{t=1}^{H}\sum_{s_t,a_t} p_\theta(s_t,a_t)r(s_t,a_t) \\ &=\sum_{t=1}^{H}\sum_i\mu_{t,i}r_i \\ &=\sum_{t=1}^{H}\mu_t^\top\mathbf{r} \\ &=\left[\sum_{t=1}^{H} \mathcal{T}_\theta^{\,t-1}\mu_1\right]^\top\mathbf{r} \end{aligned}\]즉, initial distribution $\mu_1$에서 출발해 transition matrix를 반복 적용하면 각 시간의 state-action marginal을 얻는다. 이 분포들을 모두 더한 뒤 reward vector와 내적하면 finite horizon의 expected cumulative reward가 된다.
결국 우리는 finite horizon에서의 RL objective를 state-action distribution에 대한 선형적인 형태로 이해할 수 있다.
Infinite Horizon: Average Reward와 Stationary Distribution
Average Reward의 정의
이제 horizon을 무한히 늘려서 생각해 보자. Reward를 끝없이 더하면 그 합이 수렴하지 않을 수 있으므로, 여기서는 전체 reward를 실행한 step 수로 나눈 average reward를 objective로 정의한다.
\[J_{\mathrm{avg}}(\theta) =\lim_{H\to\infty}\frac{1}{H}\sum_{t=1}^{H} \mathbb{E}_{(s_t,a_t)\sim p_\theta(s_t,a_t)}[r(s_t,a_t)]\]앞 절처럼 state와 action의 개수는 유한하고, transition과 policy는 시간에 따라 변하지 않는다고 가정한다.
Stationary Distribution과 수렴 조건
고정된 policy $\pi_\theta$가 만드는 state-action Markov chain에 다음 두 조건을 가정하자.
-
Irreducible: 서로 도달할 수 없는 영역으로 나뉘어 있지 않으며, 어떤 state에서 출발해도 다른 state로 이동할 수 있다
-
Aperiodic: 같은 state로 돌아오는 시점이 특정 주기에 묶여 있지 않다.
유한한 Markov chain이 이 조건들을 만족하면, state-action marginal $\mu_t$는 초기 분포와 무관하게 유일한 stationary distribution $\bar{\mu}_\theta$로 수렴한다.
\[\mu_t=\mathcal{T}_\theta^{\,t-1}\mu_1 \longrightarrow\bar{\mu}_\theta\]Eigenvalue 1의 의미
이번에는 $\mu_t$가 $\bar{\mu}\theta$로 수렴한다고 가정하고, 그 분포가 어떤 조건을 만족해야 하는지 살펴보자. $\mu{t+1}=\mathcal{T}_\theta\mu_t$의 양변에 극한을 취하면 다음 식을 얻는다.
\[\bar{\mu}_\theta=\mathcal{T}_\theta\bar{\mu}_\theta\]즉, stationary distribution은 transition을 한 번 더 적용해도 변하지 않는 분포이다. 이 식을 한쪽으로 정리하면 다음과 같다.
\[\bar{\mu}_\theta=\mathcal{T}_\theta\bar{\mu}_\theta \quad\Longleftrightarrow\quad (\mathcal{T}_\theta-I)\bar{\mu}_\theta=0\]여기서 $I$는 identity matrix이다. 따라서 $\bar{\mu}\theta$는 $\mathcal{T}\theta$의 eigenvalue $\lambda=1$에 해당하는 eigenspace에 속한다. 다시 말해, stationary distribution은 eigenvalue가 $1$인 eigenvector를 확률분포로 표현한 것이다. 각 성분은 $0$ 이상이어야 하고, 전체 성분의 합은 $1$이어야 한다.
Stationary Distribution으로 표현한 Objective
이제 이 stationary distribution을 RL의 objective와 연결해 보자. $\bar{p}_\theta(s,a)$를 stationary distribution에서 state-action pair $(s,a)$의 확률이라고 하자. 앞서 가정한 조건에서 state-action 분포가 수렴하면, 그 분포로 계산한 expected reward도 다음 값으로 수렴한다.
\[\mathbb{E}_{(s_t,a_t)\sim p_\theta(s_t,a_t)}[r(s_t,a_t)] \longrightarrow \mathbb{E}_{(s,a)\sim\bar{p}_\theta(s,a)}[r(s,a)] =\bar{\mu}_\theta^\top\mathbf{r}\]각 시점의 expected reward가 이 값으로 수렴하므로, 처음 $H$ step 동안의 expected reward를 평균낸 값도 $H\to\infty$일 때 같은 값으로 수렴한다. 초반에는 reward의 기대값이 달라도, 전체 step 수가 늘어날수록 그 영향은 평균에서 작아진다. 따라서 average reward objective를 다음과 같이 정리할 수 있다.
\[\begin{aligned} J_{\mathrm{avg}}(\theta) &=\lim_{H\to\infty}\frac{1}{H}\sum_{t=1}^{H}\mu_t^\top\mathbf{r} \\ &=\left[\lim_{H\to\infty}\frac{1}{H}\sum_{t=1}^{H}\mu_t\right]^\top\mathbf{r} \\ &=\mathbb{E}_{(s,a)\sim\bar{p}_\theta(s,a)}[r(s,a)] \\ &=\bar{\mu}_\theta^\top\mathbf{r} \end{aligned}\]결국 infinite horizon의 average reward objective도 stationary state-action distribution과 reward vector의 내적 $\bar{\mu}_\theta^\top\mathbf{r}$로 표현된다. Policy parameter $\theta$를 바꾸면 stationary distribution도 달라지므로, 우리는 이 내적을 최대화하는 policy를 찾으면 된다.
직관적 이해
직관적으로는 irreducible하고 aperiodic한 유한 Markov chain이 서로 오갈 수 있는 공간 안에서 특정 주기에 갇히지 않고 움직이다 보면, 어디서 출발하든 결국 같은 분포로 수렴한다고 생각하면 된다. 여기서 최종 도착지는 하나의 stationary distribution을 뜻한다.
Infinite Horizon과 Finite Horizon 비교
앞서 가정한 stationary distribution으로의 수렴 조건 아래에서, 두 objective를 나란히 쓰면 다음과 같다. Infinite horizon은 average reward를, finite horizon은 $H$ step 동안의 cumulative reward expectation을 최대화한다.
| Infinite horizon: average reward | Finite horizon: expected cumulative reward |
|---|---|
| $\displaystyle \theta^\star=\arg\max_\theta\mathbb{E}{(s,a)\sim\bar{p}\theta(s,a)}[r(s,a)]$ | $\displaystyle \theta^\star=\arg\max_\theta\sum_{t=1}^{H}\mathbb{E}{(s_t,a_t)\sim p\theta(s_t,a_t)}[r(s_t,a_t)]$ |
여기서 $\bar{p}_\theta(s,a)$는 stationary state-action distribution이다. 두 식 모두 policy parameter $\theta$를 바꾸어 expectation을 최대화한다. 각 결과가 발생할 확률을 가중치로 사용해 policy의 성능을 평균내고, 이 값이 가장 큰 policy를 찾는다.
Expectation과 Gradient
Expectation을 사용하면 reward 자체가 매끄럽지 않아도 gradient로 policy를 학습할 수 있는 경우가 있다. 예를 들어 task가 끝났을 때 성공하면 $1$, 실패하면 $0$의 reward만 받는다고 하자. 이때 trajectory의 return은 다음과 같다.
\[R(\tau)= \begin{cases} 1, & \text{success} \\ 0, & \text{failure} \end{cases}\]성공과 실패의 경계에서 reward가 갑자기 바뀌므로, reward 자체를 미분해 action을 얼마나 바꿔야 하는지 알아내기는 어렵다. 하지만 이 reward의 expectation은 policy의 성공 확률이다.
\[J(\theta) =\mathbb{E}_{\tau\sim p_\theta(\tau)}[R(\tau)] =\Pr_{\tau\sim p_\theta(\tau)}(\text{success})\]개별 결과는 $0$ 또는 $1$이어도, 성공할 확률은 policy parameter $\theta$에 따라 매끄럽게 변할 수 있다. 예를 들어 state와 action이 유한한 finite horizon 문제에서, reward와 environment가 고정되어 있고 policy의 확률이 $\theta$에 대해 smooth하면 $p_\theta(\tau)$와 $J(\theta)$도 smooth하다.
이 경우 gradient는 다음과 같이 쓸 수 있다.
\[\nabla_\theta J(\theta) =\sum_\tau R(\tau)\nabla_\theta p_\theta(\tau)\]Trajectory의 확률을 policy parameter에 대해 미분한다. 따라서 이런 조건에서는 non-smooth한 reward를 사용하더라도 distribution parameter에 대한 smooth objective를 최적화할 수 있다. 이것이 이후에 다룰 gradient-based RL이 가능한 이유 중 하나다.
05_RL의 기본 Loop
많은 RL 알고리즘은 sample을 생성하고, 그 결과를 평가하거나 model을 학습한 뒤, policy를 개선하는 과정을 반복한다.
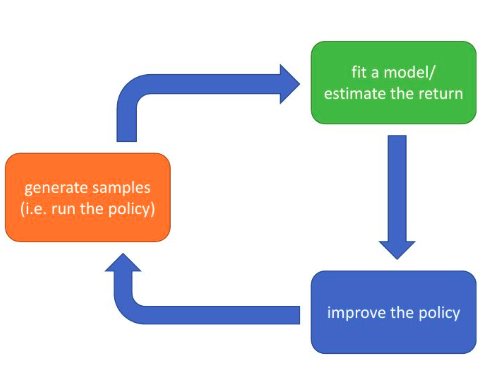
- 주황색 box — generate samples: 현재 policy를 environment에서 실행해 state, action, reward를 포함한 trajectory를 수집한다.
- 초록색 box — fit a model / estimate the return: 수집한 trajectory와 reward를 이용해 어떤 행동이 얼마나 좋았는지 평가한다. Return을 계산하거나 value function으로 추정할 수 있고, model-based 방법에서는 environment model을 학습해 이후의 결과를 예측할 수도 있다.
- 파란색 box — improve the policy: 앞 단계에서 얻은 정보를 사용해 더 높은 expected return을 얻도록 policy를 개선한다. Policy gradient 방법에서는 expected return의 gradient $\nabla_\theta J(\theta)$를 이용해 parameter를 update한다.
파란색 화살표는 개선된 policy로 다시 sample을 수집하고 같은 과정을 반복하는 흐름을 나타낸다. 이후에 다룰 RL 알고리즘은 이 각 단계를 어떻게 구현하는지에 따라 비교할 수 있다.
06_Q-function과 Value Function
Q-function과 value function은 앞으로 얻을 reward의 expectation을 state와 action을 기준으로 나타내는 함수이다. 여기서는 policy $\pi=\pi_\theta$를 따르며, 종료 시점 $H$가 정해진 finite horizon의 cumulative reward를 기준으로 정의한다. 같은 state라도 남은 시간에 따라 value가 달라질 수 있으므로, 시간 $t$를 아래 첨자로 함께 표시한다.
Q-function의 정의
$Q_t^\pi(s_t,a_t)$는 state $s_t$에서 action $a_t$를 선택하고, 그 이후에는 policy $\pi$를 따랐을 때 얻는 expected cumulative reward이다.
\[Q_t^\pi(s_t,a_t) =\sum_{t'=t}^{H} \mathbb{E}_\pi \left[r(s_{t'},a_{t'})\mid s_t,a_t\right]\]현재 action $a_t$에서 받는 reward부터 마지막 시점 $H$의 reward까지 포함한다. 따라서 Q-function은 주어진 state에서 특정 action을 선택하는 것이 얼마나 좋은지를 나타낸다.
Value Function의 정의와 Q-function과의 관계
$V_t^\pi(s_t)$는 state $s_t$에서 시작해 policy $\pi$를 따랐을 때 얻는 expected cumulative reward이다. 현재 action도 policy에 따라 선택한다.
\[V_t^\pi(s_t) =\sum_{t'=t}^{H} \mathbb{E}_\pi \left[r(s_{t'},a_{t'})\mid s_t\right]\]Q-function은 현재 action을 하나 정한 뒤 평가하고, value function은 policy가 선택할 action들까지 평균내어 평가한다. 따라서 두 함수는 다음 관계를 갖는다.
\[V_t^\pi(s_t) =\mathbb{E}_{a_t\sim\pi(\cdot\mid s_t)} \left[Q_t^\pi(s_t,a_t)\right]\]Value Function으로 표현한 RL Objective
초기 state $s_1$에서의 value는 그 state에서 시작해 episode가 끝날 때까지 얻을 expected return이다. 이를 초기 state distribution $p(s_1)$에 대해 평균내면 RL의 objective가 된다.
\[\begin{aligned} J(\theta) &=\mathbb{E}_{\tau\sim p_\theta(\tau)} \left[\sum_{t=1}^{H}r(s_t,a_t)\right] \\ &=\mathbb{E}_{s_1\sim p(s_1)} \left[V_1^{\pi_\theta}(s_1)\right] \\ &=\mathbb{E}_{(s_1,a_1)\sim p_\theta(s_1,a_1)} \left[Q_1^{\pi_\theta}(s_1,a_1)\right] \end{aligned}\]이처럼 Q-function과 value function을 정의하면, trajectory 전체의 reward를 다루던 objective를 초기 state의 value나 초기 state-action pair의 Q-value에 대한 expectation으로도 표현할 수 있다.
07_RL 알고리즘의 종류와 비교
알고리즘의 주요 범주
무엇을 학습하고 어떻게 policy를 개선하는지에 따라, RL 알고리즘을 크게 다음과 같이 나눌 수 있다.
| 범주 | 학습하는 대상 | Policy를 개선하는 방법 |
|---|---|---|
| Policy gradients | 명시적인 policy $\pi_\theta$ | Expected return의 gradient를 추정해 policy parameter를 update한다. |
| Value-based | Optimal policy의 value function 또는 Q-function | 별도의 policy network 없이, 추정한 value를 기준으로 action을 선택한다. Q-learning이 대표적인 예다. |
| Actor-critic | 현재 policy의 value를 추정하는 critic과 action을 선택하는 actor | Critic이 추정한 value 또는 Q-value를 이용해 actor의 policy를 개선한다. |
| Model-based RL | Environment의 transition model, 필요하면 reward model | Model로 planning을 하거나, policy를 개선하거나, 가상의 experience를 만들어 학습에 사용한다. |
이 범주들은 서로 결합할 수 있다. Actor-critic은 policy 학습과 value 추정을 함께 사용하며, model-based 방법도 policy나 value function을 함께 학습할 수 있다.
RL 알고리즘이 많은 이유
문제마다 data를 수집하는 비용과 학습하기 쉬운 대상이 다르기 때문에, 알고리즘을 설계할 때 중요하게 보는 기준도 달라진다.
- 서로 다른 tradeoff: 적은 sample로 학습하는 것이 중요한지, 안정적으로 학습되고 사용하기 쉬운 것이 중요한지에 따라 선택이 달라진다.
- 서로 다른 가정: Environment나 policy가 stochastic인지 deterministic인지, state와 action이 continuous인지 discrete인지, episode가 끝나는지 계속 상호작용하는 문제인지가 다르다.
- 표현하기 쉬운 대상의 차이: 어떤 문제에서는 좋은 policy를 직접 표현하기 쉽고, 다른 문제에서는 environment model이나 value function을 학습하는 것이 더 쉬울 수 있다.
Sample Efficiency와 On-policy / Off-policy
Sample efficiency는 좋은 policy를 얻기 위해 environment에서 얼마나 많은 sample을 수집해야 하는지를 뜻한다. 이미 수집한 data를 얼마나 재사용할 수 있는지가 여기에 큰 영향을 준다.
On-policy와 off-policy는 data를 수집하는 behavior policy와 학습하려는 target policy의 관계로 구분한다.
- Off-policy: 학습하려는 policy가 직접 생성하지 않은 sample도 사용할 수 있다. 따라서 policy를 개선할 때마다 새 sample을 수집하지 않고, 이전 policy나 다른 policy가 수집한 data를 재사용할 수 있다. 다만 필요한 state-action pair에 대한 경험이 충분히 있어야 한다.
- On-policy: 기본적으로 현재 학습하려는 policy가 생성한 sample을 사용한다. Policy가 바뀌면 이전 data의 분포가 새 policy와 달라지므로, 새 policy로 sample을 다시 수집해야 한다. 기본적인 on-policy policy gradient가 여기에 해당한다.
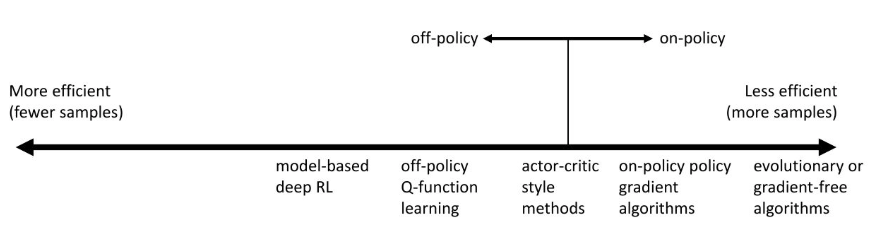
그림의 가로축은 왼쪽으로 갈수록 좋은 policy를 얻는 데 필요한 sample이 적고, 오른쪽으로 갈수록 많다는 뜻이다. 위쪽 화살표는 off-policy와 on-policy를 대략적으로 대비한다. 이는 강의에서 설명하는 전반적인 경향이며, 실제 sample efficiency는 task, model의 정확도, 알고리즘의 구체적인 설계에 따라 달라진다. Actor-critic도 on-policy와 off-policy 방식이 모두 존재한다.
또한 sample efficiency와 실제 학습 시간은 다르다. 적은 sample을 사용하더라도 model 학습이나 planning에 많은 계산이 필요하면 전체 학습 시간은 더 길어질 수 있다.
Stability와 Ease of Use
안정성을 볼 때는 학습이 수렴하는지, 수렴한다면 어떤 값이나 policy에 도달하는지, 다시 실행해도 비슷한 결과를 얻는지를 함께 봐야 한다. Learning rate나 다른 hyperparameter를 얼마나 세심하게 조정해야 하는지도 사용 편의성과 관련된다.
일부 tabular 알고리즘은 충분한 탐색과 적절한 learning rate 같은 조건 아래에서 수렴이 보장된다. 하지만 이 보장이 비선형 neural network를 사용하는 deep RL에 그대로 적용되지는 않는다. 실제 학습에서는 parameter 설정과 data 분포 등에 따라 결과가 달라질 수 있으며, 수렴하더라도 좋은 policy를 얻었다고 단정할 수는 없다.
Value Function Fitting의 수렴과 성능
Value function fitting은 보통 Bellman equation에 맞도록 value를 학습하며, 이때의 fitting error를 Bellman error라고 부른다. Policy의 성능은 실제 실행에서 얻는 expected reward로 평가한다. 방문하지 못한 state나 action의 value가 부정확하면, 학습한 data에서의 error가 작아도 실제 policy의 성능은 좋지 않을 수 있다.
또한 bootstrapping에서는 학습 target에 현재 value estimate가 들어가므로, 학습이 진행되면서 target도 바뀐다. 따라서 일부 value update는 하나의 고정된 objective를 gradient descent로 최소화하는 과정으로 해석할 수 없다. 특히 비선형 함수 근사를 사용하는 많은 deep RL value-fitting 방법에는 일반적인 수렴 보장이 없으며, 학습이 진동하거나 발산할 수도 있다.